
1
/
of
1
BHV-CПб
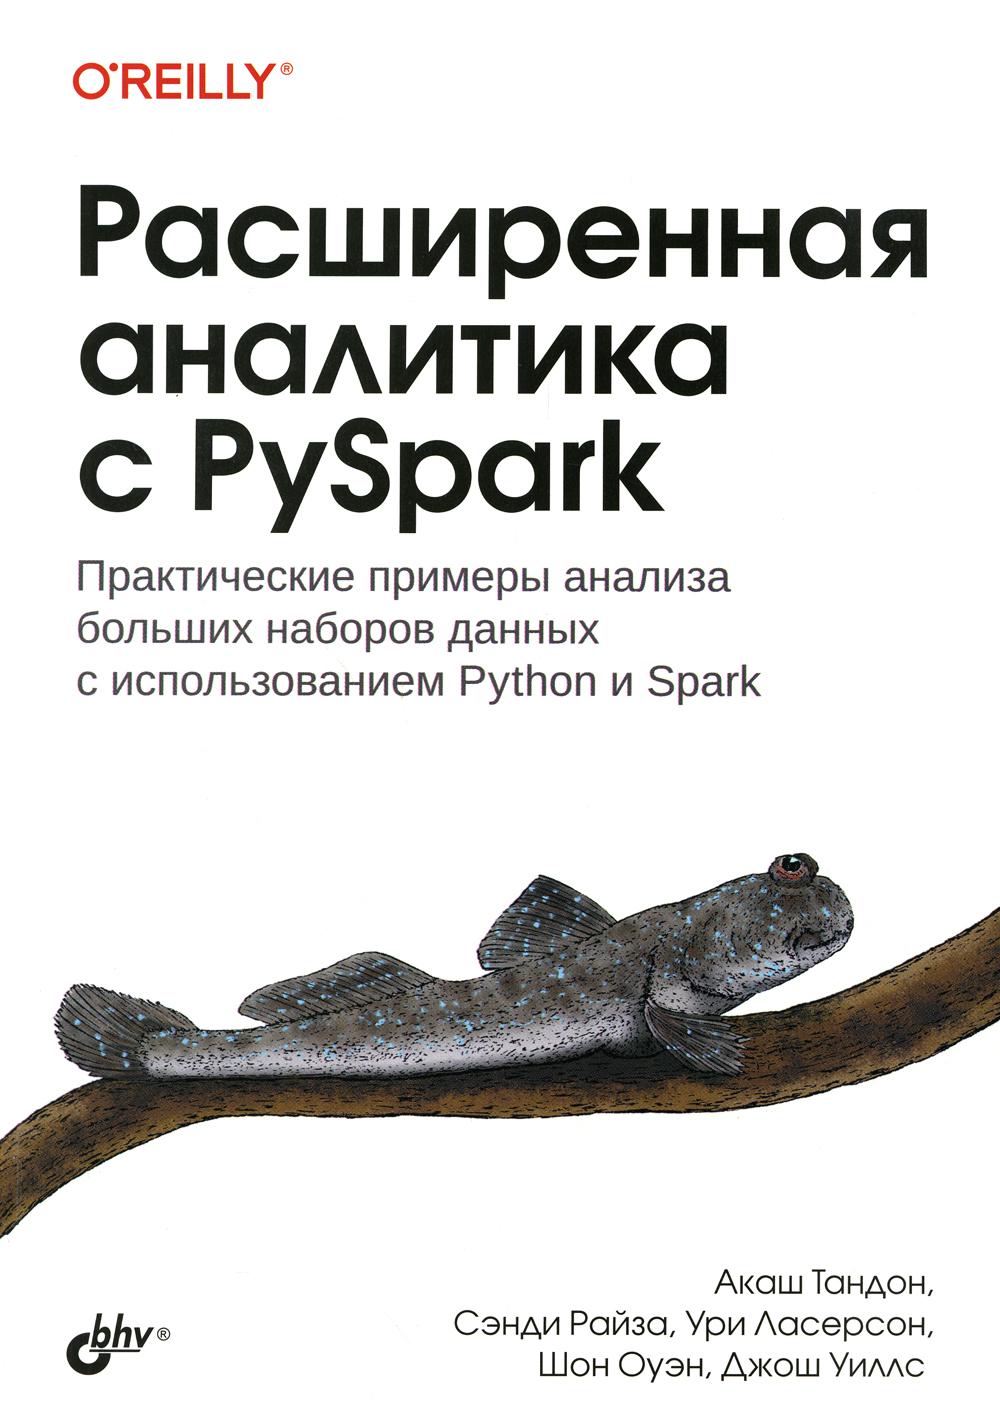
Расширенная аналитика с PySpark
Расширенная аналитика с PySpark
Regular price
$45.35 CAD
Regular price
Sale price
$45.35 CAD
Unit price
/
per
Couldn't load pickup availability
Product details
- Authors :
- Binding : Paperback
- Coverage : 1
- Ean : 9785977517706
- Handling Time : 20 days
- Isbn : 978-5-9775-1770-6
- Pages : 224
- Publication Year : 2026
- Publisher :
- Series : Внесерийные книги
Handling time: 20 days Книга посвящена практическим методам анализа больших объемов данных с использованием языка Python и фреймворка Spark, она знакомит с моделью программирования Spark и основами системы с открытым исходным кодом PySpark. Каждая глава описывает отдельный аспект анализа данных, показаны основы обработки данных в PySpark и Python на примере очистки данных, подробно освещается машинное обучение с помощью Spark. Книга поможет читателю понять, как устроен и работает весь конвейер PySpark для комплексной аналитики больших наборов данных: от создания и оценки моделей до очистки, предварительной обработки и исследования данных с особым акцентом на производственные приложения. Отдельные главы посвящены обработке изображений и библиотеке Spark NLP. Для специалистов по обработке данных и машинному обучению Практические примеры анализа больших наборов данных с использованием Python и Spark В современном мире накоплен ошеломляющий объем данных, и он продолжает расти. Один из основных инструментов анализа данных — Apache Spark, фреймворк с открытым исходным кодом для распределенной обработки неструктурированных и слабоструктурированных данных. Это практическое руководство объединяет Spark, статистические методы и наборы данных из реального мира. Авторы научат вас решать задачи анализа с помощью системы с открытым исходным кодом PySpark, применяемой для распределенной обработки больших данных с использованием Python, а также других передовых методов программирования Spark. Специалисты по обработке данных знакомят читателей с экосистемой Spark, а затем приводят примеры базовых методов анализа, включая классификацию, кластеризацию, совместную фильтрацию и обнаружение аномалий в таких областях, как геномика, безопасность и финансы. Отдельные главы посвящены обработке изображений и библиотеке Spark NLP. Если у вас имеются базовые знания о машинном обучении и статистике, и вы программируете на Python, книга поможет вам освоить анализ больших данных. Ознакомьтесь с моделью программирования и экосистемой Spark Изучите общие подходы в науке о данных Изучите практические примеры анализа больших наборов данных Узнайте, какие инструменты машинного обучения подходят для решения конкретных задач Напишите код, который можно адаптировать для многих целей Об авторе Акаш Тандон — cоучредитель и технический директор компании Looppanel. Ранее работал главным инженером по данным в компании Atlan, специализирующейся на обработке данных и аналитике. Сэнди Райза — ведущий разработчик проекта Dagster, облачного оркестратора для анализа данных, и участник проекта Apache Spark. Ури Ласерсон — учредитель и технический директор компании Patch Biosciences, специализирующей в области геномики и расшифровки ДНК. Ранее работал с большими данными в Cloudera, создателе дистрибутивов Apache Hadoop. Шон Оуэн — главный архитектор решений, специализирующийся на машинном обучении и науке о данных в Databricks, компании по разработке корпоративного программного обеспечения, основанной создателями Apache Spark. Участник проекта Apache Spark. Джош Уиллс — инженер-программист в компании WeaveGrid, развивающей «зеленые» технологии в сфере энергетики, и бывший руководитель отдела обработки данных в компании Slack Tecnologies, разработавшей одноименный корпоративный мессенджер .
#ASTTD# Search Terms: Ури Ласерсон,Акаш Тандон,Сэнди Райза , Yri Laserson,Akash Tandon,Sendi Raiza , BHV-CПб , BHV-CPb , Внесерийные книги , Vneseriinie knigi , 9785977517706 , 978-5-9775-1770-6 , 1905691
#ASTTD# Search Terms: Ури Ласерсон,Акаш Тандон,Сэнди Райза , Yri Laserson,Akash Tandon,Sendi Raiza , BHV-CПб , BHV-CPb , Внесерийные книги , Vneseriinie knigi , 9785977517706 , 978-5-9775-1770-6 , 1905691
Share

Isbn:
978-5-9775-1770-6Ean:
9785977517706
HandlingTime:
20 days
Publisher:
BHV-CПб
Binding:
Paperback
Pages:
224


1
/
of
2
Ordered
Oct 31
Order Ready
Nov 20
Delivered
Nov 22 - Nov 28